别再手动拼 URL 了:一次中文参数乱码背后的完整编码链路排查
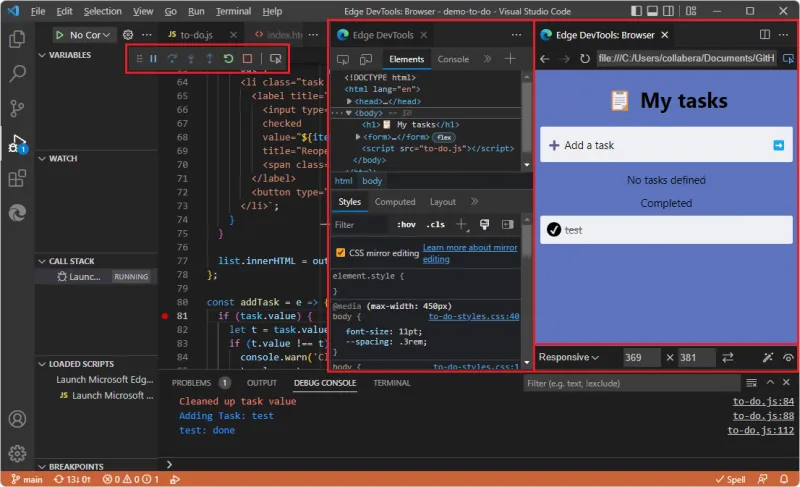
Photo: developer debugging network request browser devtools screen, via learn.microsoft.com
上周帮朋友排查一个线上问题:他做的是一个面向华人用户的本地服务平台,用户搜索「旧金山 中餐」,结果后端日志里躺着一串 %E4%B8%AD%E9%A4%90 和偶发的 ??。前端说「我编码了」,后端说「我解码了」,中间这段链路,没人真正看过。
这正是 URL 编码最坑的地方:它不是一次编码,而是一条链。任何一环多编或少编一次,中文就会在你眼前变形。
先分清两个最容易混淆的函数
JavaScript 里有两个长得很像的函数,职责却完全不同:
encodeURI():编码整个 URL,但故意保留?、&、=、/这些结构字符。适合「我有一整个 URL 要放进地址栏」的场景。encodeURIComponent():编码一个参数值,连&和=也不放过。适合「我要把这个值塞进 query string」的场景。
经典翻车现场:用户搜索内容里包含 & 或 +,开发者用了 encodeURI,结果 & 被当成参数分隔符,后端把一个参数拆成了两个。记住一条铁律:拼参数用 encodeURIComponent,只有整条 URL 才轮到 encodeURI。
另外别用已被废弃的 escape()——它对中文的处理不符合 UTF-8 标准,老项目里见到就顺手替换掉。
一条中文参数的旅程
以「中餐」为例,完整链路大概是这样:
- 浏览器发起请求:
encodeURIComponent("中餐")产出%E4%B8%AD%E9%A4%90(每个汉字三个 UTF-8 字节)。 - 服务器框架解码:Spring、Express、Rails 等框架默认会自动 decode 一次 query string,你拿到的已经是原文。
- 常见坑一:双重编码。前端编码了一次,网关或某个中间件又编了一次,后端解码后得到
%E4%B8%AD%E9%A4%90这个「看起来像编码」的字符串。 - 常见坑二:
+与%20之争。application/x-www-form-urlencoded规范里空格是+,而encodeURIComponent产出的是%20。某些服务端解析器只认其一,空格就成了+字面量。 - 常见坑三:Tomcat / Nginx 的字符集配置。请求体解码用的不是 UTF-8(比如默认 ISO-8859-1),中文直接变成
????。
五分钟排查清单
下次遇到乱码,按这个顺序走一遍,基本都能定位:
- 看原始请求:打开浏览器 DevTools 的 Network 面板,确认发出的 URL 里是
%E4%B8%AD这种正确的 UTF-8 百分号编码,还是已经变成了别的。 - 确认编码次数:在后端入口处打印原始 query string(解码前),如果里面还有
%,说明被多编了一次,去查网关和中间件。 - 检查框架自动解码:确认你没有在框架已经解码之后,再手动
decodeURIComponent一次。 - 查服务端字符集:Tomcat 的
URIEncoding、Nginx 的charset、数据库连接串的characterEncoding,三处都要是 UTF-8。 - 验证空格语义:如果参数里有空格,确认客户端和服务端对
+的理解一致,必要时统一用%20。
现代 HTTP 库能帮你多少?
fetch 的 new URLSearchParams({q: "中餐"})、Axios 的 params 选项、以及绝大多数框架的路由参数,都会自动做正确的事。手动拼 URL 字符串是乱码的头号来源。除非你明确知道自己在处理一段已经编码过的字符串,否则把编码交给库,把时间留给业务逻辑。
URL 编码本身不复杂,复杂的是链路上每一环都「以为别人处理了」。把这条链路画出来贴在工位上,下次乱码出现时,你会感谢自己的。